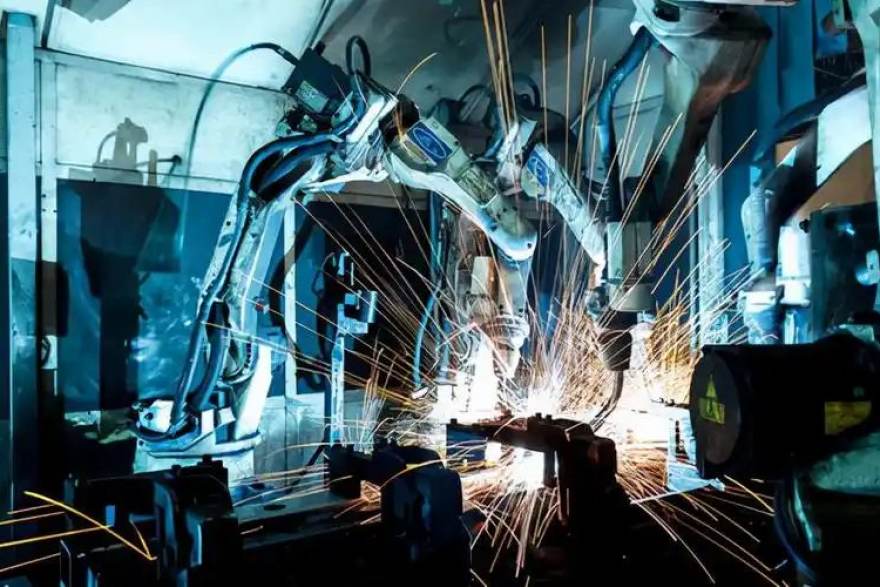
为什么今年要重新盘点边缘网关的防护能力
走到2026年下半年,制造企业对边缘计算的期待已经明显变化。早几年大家关心的是“网关能不能把设备数据采上来”,现在问得更多的是“采上来之后,异常能不能在本地就被拦住”。PG直营站在多个项目复盘中发现,产线异常防护的效果,往往不取决于云端算法多强,而取决于边缘侧那台网关的判定速度与联动深度。换句话说,网关不再只是通道,而是产线防护的第一道闸门。
本次盘点不追求排名,而是把PG直营站接触到的六类典型表现拆开看,帮助现场工程师对照自家产线做判断。需要说明的是,文中涉及的产线名称与人物均为化名,数据为示例数据,仅用于说明趋势。
六类表现逐一拆解
第一类:协议接入的“容忍度”。在恒瑞精密部件的冲压车间,产线上同时跑着三种不同年代的设备,协议版本跨度大。边缘网关能否在不改设备程序的前提下完成接入,直接决定了项目周期。PG直营站观察到,具备自适应协议解析能力的网关,现场调试时间通常能压缩三成左右(示例数据)。
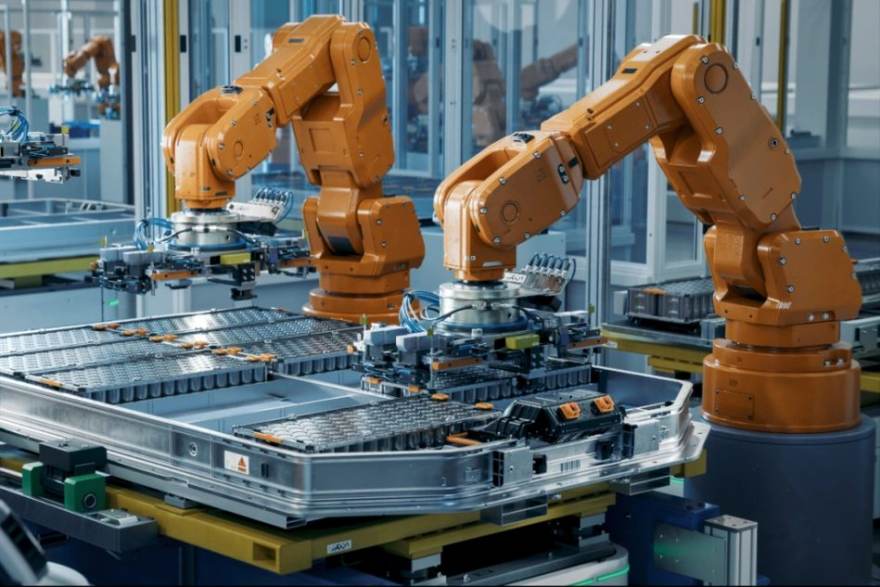
第二类:异常判定的“本地化程度”。把判定逻辑全部放在云端,网络一抖就误报。在蓝湾新能源的模组产线,网关侧内置了阈值与趋势双重判定,夜间值守的误报率明显下降。PG直营站认为,判定下沉不是替代云端,而是把“来不及上云”的那部分先处理掉。
第三类:断网续传的“完整性”。网络波动在工厂是常态。网关本地缓存策略是否合理,决定了恢复后数据链是否断裂。明远汽车零部件的焊装线做过一次断网演练,缓存机制完善的网关在恢复后数据补齐完整,追溯链条没有缺口。
第四类:联动响应的“闭环速度”。发现异常只是开始,能否在毫秒级触发停机、报警或工位提示,才是防护的落点。PG直营站看到,具备本地联动引擎的网关,从判定到动作的链路更短,现场工程师的干预负担也更轻。
第五类:边缘算力的“余量设计”。不少项目上线时够用,半年后接入设备翻倍就吃紧。星禾电子组装的贴片线在扩容时,算力余量充足的网关无需更换硬件,避免了二次投资。
第六类:运维可视的“透明度”。网关本身也是设备,它的健康状态需要被看见。PG直营站建议把网关纳入统一监控,避免“防护者自身失守”。
给现场工程师的对照建议
- 先梳理产线协议清单,再谈网关选型,顺序反了容易返工。
- 把异常判定分成“必须本地”和“可以上云”两档,边界清晰后再部署。
- 断网演练要做,且要覆盖夜班时段,白天测不出真实问题。
- 算力余量按未来一到两年接入量估算,别只按当下设备数配。
- 网关监控纳入既有运维体系,避免形成新的信息孤岛。
整体来看,2026年的边缘计算网关已经从“能连”走向“能判、能联动、能自证”。PG直营站在云研发与方案中心的实践中,持续把这类观察沉淀进产品迭代说明,帮助制造企业把黑灯工厂的防护底座打得更稳。想进一步对照具体方案,可在PG直营站客户端(安卓、苹果 iOS、Windows 电脑版、Mac 电脑版)查看产品迭代说明与项目复盘文章。
断网演练那条太真实了,我们去年白天测一切正常,夜班一跑就露馅,后来补了缓存策略才稳住。
协议接入的容忍度这点有共鸣,老设备改程序成本太高,能自适应解析确实省事。
判定下沉我持保留意见,本地规则维护不好也会变成新负担,得看团队能力。
算力余量真别省,我们扩容时换了一批网关,教训深刻。
网关自身监控这条建议加一,之前网关挂了没人知道,数据断了半天才发现。